🐘 Коллекция готовых SQL запросов для PostgreSQL
Получение пользовательских данных
- Валидация и домены
- Как проверить email на валидность?
- Как найти все невалидные email в таблице?
- Как удалить все невалидные email из большой таблицы?
- Как проверить CSS цвет на валидность?
- Как проверить реквизиты компании (ИНН, КПП, ОГРН, ОГРНИП) на валидность?
- Как проверить банковские реквизиты (БИК, расчётный счёт, корреспондентский счёт) на валидность?
- Как проверить СНИЛС на валидность?
- Как проверить номер телефона на валидность?
- Как провалидировать значение поля, только если оно явно указано в UPDATE запросе?
- Переезд из MySQL/MariaDB в PostgreSQL
- Как сделать аналог функции
group_concat() из MySQL
- Как сделать аналог типа
set из MySQL?
- Как сделать аналог функции
make_set() из MySQL?
- Файлы
- Как выгрузить результат SELECT запроса в
CSV файл?
- Как загрузить в таблицу данные из
CSV файла?
- Шпаргалка по выгрузке и загрузке
CSV файлов в PostgreSQL
- Строки
- Как транслитерировать русские буквы на английские?
- Как распарсить CSV строку в таблицу?
- Как определить пол по ФИО (фамилии, имени, отчеству) на русском языке?
- Как заквотировать строку для использования в регулярном выражении?
- Как заквотировать строку для использования в операторе LIKE?
- JSON
- Как получить записи, которые удовлетворяют условиям из JSON массива?
- Как сравнить 2 JSON объекта и получить отличия?
- Массивы
- Агрегатная функция конкатенации (объединения) массивов
- Как получить одинаковые элементы массивов (пересечение массивов)?
- Как получить уникальные элементы массива или отсортировать их?
- Как получить отличающиеся элементы двух массивов?
- Как сделать внешний ключ на элементы массива?
- Поиск по фразе (точный и неточный)
- Как найти список строк, совпадающих со списком шаблонов?
- Как получить названия сущностей по поисковой фразе с учётом начала слов (поисковые подсказки)?
- Как для слова с опечаткой (ошибкой) получить наиболее подходящие варианты слов для замены (исправление опечаток)?
- Деревья и графы
- Как получить список названий предков и наследников для каждого узла дерева (на примере регионов)?
- Как получить циклические связи в графе?
- Как защититься от циклических связей в графе?
- Как получить названия всех уровней сферы деятельности 4-го уровня?
- Оптимизация выполнения запросов
- Как посмотреть на план выполнения запроса (EXPLAIN) в наглядном графическом виде?
- Как ускорить SELECT запросы с тысячами значений в IN(...)?
- Как использовать вывод EXPLAIN запроса в другом запросе?
- Как ускорить SELECT запрос после переезда с PostgreSQL v10 на v12?
- Как ускорить SELECT COUNT(*) запрос?
- Как выполнить функцию N тысяч раз и измерить скорость выполнения?
- Как получить записи-дубликаты по значению полей?
- Как получить длительность выполнения запроса в его результате?
- Как разбить большую таблицу по N тысяч записей?
- Как выполнить следующий SQL запрос, если предыдущий не вернул результат?
- Как развернуть запись в набор колонок?
- Как получить итоговую сумму и процент для каждой записи в одном запросе?
- Как получить возраст по дате рождения?
- Как получить дату или дату и время в формате ISO-8601?
- Как вычислить дистанцию между 2-мя точками на Земле по её поверхности в километрах?
- Как найти ближайшие населённые пункты относительно заданных координат?
- Как вычислить приблизительный объём данных для результата SELECT запроса?
- Почему запрос с подзапросом в NOT IN() возвращает 0 записей?
- Особенности сравнения record и NULL
- Как очень быстро получить количество записей в большой таблице?
- Как сделать рекурсивный запрос?
Модификация пользовательских данных (DML)
- Как добавить или обновить записи одним запросом (UPSERT)?
- Как сделать
INSERT ... ON CONFLICT ... без увеличения последовательности для дубликатов?
- Как ускорить добавление строк через
INSERT ... VALUES ...?
- Как модифицировать данные в нескольких таблицах и вернуть id затронутых записей в одном запросе?
- Как модифицировать данные в связанных таблицах одним запросом?
- Как добавить запись с id, значение которого нужно сохранить ещё в другом поле в том же INSERT запросе?
- Как сделать несколько последующих запросов с полученным при вставке id из первого запроса?
- Как не обновлять запись, если данные из UPDATE запроса и в БД совпадают?
- Как обновить запись так, чтобы не затереть чужие изменения, уже сделанные кем-то?
- Как обновить несколько записей разными данными в одном запросе?
- Как обновить или удалить миллионы записей в таблице не блокируя все записи и не нагружая БД?
- Как удалить десятки тысяч записей в таблице не блокируя все записи и не нагружая БД?
- Как для одной сущности сделать ограничение на количество вставляемых зависимых сущностей?
- Как сделать журналирование изменений таблицы?
- Как сделать автоматически обновляемое поле
updated_at?
Модификация схемы данных (DDL)
- Как добавить колонку в существующую таблицу без её блокирования?
- Как добавить ограничение таблицы, если оно ещё не существует?
- Как изменить ограничение внешнего ключа без блокирования таблицы?
- Как проверить, что при добавлении или обновлении записи заполнены N полей из M возможных?
- Как из enum типа удалить значение?
- Как найти все упоминания названия объекта БД по всей БД?
- Как изменить тип колонки с
int на bigint?
- Как восстановить значение последовательности, если оно отстало?
Индексы
- Как создать или пересоздать индекс в существующей таблице без её блокирования?
- Как сделать составной уникальный индекс, где одно из полей может быть null?
- Как починить сломаный уникальный индекс, имеющий дубликаты?
- Как временно отключить индекс?
- Как сделать компактный уникальный индекс на текстовое поле?
Администрирование
- Как получить список процессов с SQL запросами, выполняющихся сейчас?
- Как остановить или завершить работу процессов?
- Как получить список всех функций БД, включая триггерные процедуры?
- Как получить список всех зависимостей (внешних ключей) между таблицами БД?
- Как получить статистику использования индексов?
- Как получить список установленных расширений (extensions)?
- Как получить список таблиц с размером занимаемого места и примерным количеством строк?
- Как получить список самых ресурсоёмких SQL запросов?
- Как получить список SQL запросов, создающих временные файлы?
- Как получить и изменить значения параметров конфигурации выполнения?
- Как получить все активные в данный момент процессы автовакуумa и время их работы?
- Как узнать, почему время ответа от базы периодически падает?
- Как обезопасить приложение от тяжёлых миграций, приводящих к блокированию запросов?
- Simple index checking
- Как скопировать базу данных?
- Как проверить синтаксис SQL кода без его выполнения?
- Как откатить часть транзакции внутри функции или процедуры?
- Как терминировать долгие простаивающие без дела подключения к БД?
- Как терминировать заблокированные одинаковые запросы, образующие очередь?
- Как журналировать DDL команды в таблицу БД?
- Как узнать, какие самые частые действия в таблице совершаются?
- Как узнать отставание реплик?
- Как узнать процент достижения своего максимального значения для последовательностей?
- Как удалить неиспользуемые WAL файлы?
- Как удалить роль, которая имеет принадлежащие ей объекты?
- Как сравнить конфигурации двух СУБД?
- Как получить топологию кластера СУБД?
Получение пользовательских данных
Как проверить email на валидность?
Домен email.sql (валидация базовая минимальная, но быстрая) и функция is_email.sql (валидация почти по спецификации, но медленная)
Как найти все невалидные email в таблице?
SELECT email
FROM person_email
WHERE email IS NOT NULL    -- skip NULL
      AND email !~ '^\s*$' -- skip empty (similar NULL for NOT NULL column)
      NOT(
        AND octet_length(email) BETWEEN 6 AND 320 -- https://en.wikipedia.org/wiki/Email_address
        AND email LIKE '_%@_%.__%'                -- rough, but quick check email syntax
        AND is_email(email)                       -- accurate, but slow check email syntax
    );
Функция is_email.sql
Как удалить все невалидные email из большой таблицы?
Если строк в таблице немного и запрос работает относительно быстро, то подойдёт простой DELETE FROM table_name WHERE ....
Если в таблице миллионы строк, то процесс может занятуться надолго.
При этом записи в таблице так же заблокируются надолго, а конкурентные запросы на модификацию записей, которые связаны с этой таблицей, выстроятся в очередь.
Решение — удалять нужно не всё сразу, а по частям.
Пример см. loop_execute
Как проверить CSS цвет на валидность?
Домен: css_color.sql
Как проверить реквизиты компании (ИНН, КПП, ОГРН, ОГРНИП) на валидность?
Домены: inn.sql, inn10.sql, inn12.sql.
Функции: is_inn10.sql, is_inn12.sql.
Домен: kpp.sql.
Функция: is_kpp.sql.
Домен: ogrn.sql.
Функция: is_ogrn.sql.
Домен: ogrnip.sql.
Функция: is_ogrnip.sql.
Как проверить банковские реквизиты (БИК, расчётный счёт, корреспондентский счёт) на валидность?
Домен: bik.sql.
Функция: is_bik.sql.
Банковский расчётный (клиентский) счёт (р/с)
Домен: client_account.sql.
Функция: is_client_account.sql.
Банковский корреспонденткий счёт (к/с)
Домен: correspondent_account.sql.
Функция: is_correspondent_account.sql.
Как проверить СНИЛС на валидность?
Домен: snils.sql.
Функция: is_snils.sql.
Как проверить номер телефона на валидность?
Домен phone.sql для валидации номера телефона в международном формате E.164
См. ещё функции:
phone_normalize.sqlphone_parse.sqlphone_format.sqlphone_format_record.sql
Как провалидировать значение поля, только если оно явно указано в UPDATE запросе?
Ограничения CHECK() для каждого поля таблицы срабатывают каждый раз при добавлении или обновлении записи таблицы. При добавлении записи всё логично — значение нужно проверить, даже если это значение по-умолчанию. Однако, в запросе на обновление даных даже неважно, изменилось значение поля на самом деле или нет (ну почему так сделано?). Если в CHECK проверка ресурсоёмая, то она может существенно замедлить обновление большого количества записей в таблице. Пример ресурсоёмкой проверки — валидация синтаксиса email функцией is_email().
Обойти данную проблему можно с использованием триггеров.
Предположим, есть таблица person с колонкой email.
CREATE OR REPLACE FUNCTION person_email_check() RETURNS TRIGGER
    LANGUAGE plpgsql AS
$$
BEGIN
    IF NOT is_email(NEW.email) THEN
        RAISE EXCEPTION 'Email % is not valid', NEW.email;
    END IF;
    RETURN NEW;
END;
$$;

-- добавление
DROP TRIGGER IF EXISTS person_email_check_insert ON person_email;
CREATE TRIGGER person_email_check_insert
    BEFORE INSERT ON person
    FOR EACH ROW
    WHEN (NEW.email IS NOT NULL
          AND NEW.email !~ '^\s*$')
    EXECUTE PROCEDURE person_email_check();

--обновление
DROP TRIGGER IF EXISTS person_email_check_update ON person_email;
CREATE TRIGGER person_email_check_update
    BEFORE UPDATE OF email ON person -- поле явно указано в UPDATE запросе!
    FOR EACH ROW
    WHEN (NEW.email IS NOT NULL
          AND NEW.email !~ '^\s*$'
          AND NEW.email IS DISTINCT FROM OLD.email) -- значение изменилось
    EXECUTE PROCEDURE person_email_check();
Переезд из MySQL/MariaDB в PostgreSQL
There isn’t anything MySQL can do that PostgreSQL can’t do.
However, there are things that PostgreSQL can do that MySQL can’t do.
http://mysqltopgsql.com/
Как сделать аналог функции group_concat() из MySQL
SELECT STRING_AGG(DISTINCT s, ', ' ORDER BY s) AS field_alias FROM (VALUES ('b'), ('a'), ('b')) AS t(s); -- a, b

SELECT ARRAY_TO_STRING(ARRAY_AGG(DISTINCT s ORDER BY s), ', ') AS field_alias FROM (VALUES ('b'), ('a'), ('b')) AS t(s); -- a, b
Как сделать аналог типа set из MySQL?
Используйте комбинацию перечисляемого типа и массива. Пример:
CREATE TYPE finger_type AS ENUM ('one', 'two', 'three', 'four', 'five');
CREATE TABLE my_table (
    fingers finger_type[] CHECK(/*cardinality(fingers) > 0 and*/
                                cardinality(array_unique(fingers)) = cardinality(fingers) --проверка на уникальность
                               )
);
Дополнительно смотри array_unique.sql
Как сделать аналог функции make_set() из MySQL?
select to_json(array_agg(name))
from unnest(array['a','b','c', 'd']::text[]) with ordinality as s(name, num)
where 10 & (1 << (num::int-1)) > 0;

select array_agg(name)
from unnest(string_to_array('a,b,c,d', ',')) with ordinality as s(name, num)
where 10 & (1 << (num::int-1)) > 0;Как выгрузить результат SELECT запроса в CSV файл?
Файл select.sql
copy (
    select id, send_date::timestamp(0), message
    from my_table
    where send_date > now() - interval '2 month'
    --limit 100
) to stdout (format csv, header false);
# без сжатия
sudo su - postgres -c "psql -qX --csv --file=select.sql" > select.csv
sudo su - postgres -c "psql -qX --csv -c 'select * from pg_stat_activity'" > select.csv
# с сжатием (размер файла больше, но работает быстрее)
cat select.sql | psql -U postgres -qX --dbname=my_database | zstd -19 -T8 -o select.csv.zst
# с сжатием (размер файла меньше, но работает медленнее)
cat select.sql | psql -U postgres -qX --dbname=my_database | xz -zc9 --threads=8 > select.csv.xz
Как загрузить в таблицу данные из CSV файла?
Воспользуйтесь утилитой psql.
Особенность мета-команды \copy в том, что она читает файл из локальной файловой системы и пересылает его на сервер на вход SQL команде COPY.
# без сжатия
\copy test.regions from '/tmp/regions.csv' with (format csv, header false);

# с сжатием
\copy test.regions from program 'xzcat regions.csv.xz' with (format csv, header false);
Шпаргалка по выгрузке и загрузке CSV файлов в PostgreSQL
-- выгрузка таблицы в CSV в поток
COPY public.events TO STDOUT WITH (FORMAT csv, HEADER true);

-- загрузка из CSV из потока
COPY public.events FROM STDIN WITH (FORMAT csv, HEADER true);

-- загрузка из файла на сервере (нужны права)
COPY public.events FROM '/var/lib/postgresql/import.csv' WITH (FORMAT csv, HEADER true);

-- через внешнюю программу (распаковка на лету)
COPY public.events FROM PROGRAM 'gzip -dc /data/import.csv.gz' WITH (FORMAT csv, HEADER true);

-- выгрузка результата запроса, не всей таблицы
COPY (
  SELECT id, payload, created_at
  FROM public.events
  WHERE created_at >= DATE '2025-01-01'
) TO STDOUT WITH (FORMAT csv, HEADER true);
Всё о транслитерации
Современные функции транслитерации по правилам библиотеки "Юлия":
- iuliia_translate_mosmetro.sql
- iuliia_translate_wikipedia.sql
Устаревшая функции транслитерации slugify_ru.sql
Как распарсить CSV строку в таблицу?
PostgreSQL умеет читать и писать CSV в файл на сервере БД. А это парсер CSV из строки. Смотри csv_parse.sql
Область применения — массовое добавление и обновление записей в таблицах БД через SQL миграции БД и административные интерфейсы.
Выполнить SQL
Запрос
select
    CASE WHEN row[1] ~ '^\d+$' THEN row[1]::integer ELSE NULL END AS id,
    row[2] AS kladr_id,
    row[3] AS name
from csv_parse($$
id; kladr_id; name
501 ; 8300000000000 ; ";Автономный ;"";округ""
  ""Ненецкий"";";unknown
      751;8600800000000; "  Автономный округ ""Ханты-Мансийский"", Район Советский" ;
     1755;8700300000000;  Автономный округ Чукотский, Район Билибинский
     1725;7501900000000;Край Забайкальский, Район Петровск-Забайкальский

  ;;
       711;2302100000000;Край Краснодарский, Район Лабинский
       729;2401600000000;Край Красноярский, Район Иланский
       765;2700700000000;Край Хабаровский, Район Вяземский
       765;;
$$, ';', false) as row;
Результат
| id |
kladr_id |
name |
| <null> |
kladr_id |
name |
| 501 |
8300000000000 |
;Автономный ;";округ"\n"Ненецкий"; |
| 751 |
8600800000000 |
Автономный округ "Ханты-Мансийский" |
| 1755 |
8700300000000 |
Автономный округ Чукотский |
| 1725 |
7501900000000 |
Край Забайкальский |
| 711 |
2302100000000 |
Край Краснодарский |
| 729 |
2401600000000 |
Край Красноярский |
| 765 |
2700700000000 |
Край Хабаровский |
| 765 |
<null> |
<null> |
Как определить пол по ФИО (фамилии, имени, отчеству) на русском языке?
Как заквотировать строку для использования в регулярном выражении?
Смотри quote_regexp.sql
Как заквотировать строку для использования в операторе LIKE?
Смотри quote_like.sql
Как получить записи, которые удовлетворяют условиям из JSON массива?
SELECT * FROM (
    VALUES ('[{"id" : 1, "created_at" : "2003-07-01", "name": "Sony"},
              {"id" : 2, "created_at" : "2008-10-27", "name": "Samsung"}]'::jsonb),
           ('[{"id" : 3, "created_at" : "2010-03-30", "name": "LG"},
             {"id" : 4, "created_at" : "2018-12-09", "name": "Apple"}]'::jsonb)
) AS t
WHERE EXISTS(
          SELECT *
          FROM jsonb_to_recordset(t.column1) AS x(id int, created_at timestamp, name text)
          WHERE x.id IN (1, 3) AND x.created_at > '2000-01-01' AND name NOT LIKE 'P%'
      );
Как сравнить 2 JSON объекта и получить отличия?
Смотри jsonb_object_diff.sql
Агрегатная функция конкатенации (объединения) массивов
Смотри array_cat_agg.sql
Как получить одинаковые элементы массивов (пересечение массивов)?
-- для 2-х массивов
select array_agg(a)
from unnest(array[1, 2, 3, 4, 5]) a
where a = any(array[4, 5, 6, 7, 8]); -- {4,5}

-- для N массивов
select array_agg(a1)
from unnest(array[1, 2, 3, 4, 5]) a1
inner join unnest(array[3, 4, 5, 6, 7]) a2 on a1 = a2
inner join unnest(array[4, 5, 6, 7, 8]) a3 on a1 = a3; -- {4,5}
Как получить уникальные элементы массива или отсортировать их?
Для int[] лучше воспользоваться готовыми функциями uniq() и sort() из модуля intarray.
Смотри функции array_unique.sql
и array_unique_stable.sql
Как получить отличающиеся элементы двух массивов?
Смотри функцию array_diff.sql
Как сделать внешний ключ на элементы массива?
Нельзя использовать колонку-массив для хранения элементов, значения которых ссылаются на значения колонки из другой таблицы по внешнему ключу (FK). Это не соответствует первой нормальной форме в реляционной модели данных. Необходимо использовать дополнительную таблицу в отношении "один ко многим". Так же в этом случае для поддержки целостности данных по внешним ключам и исключению дубликатов доступны штатные механизмы.
Однако, технически это возможно. Ниже пример проверки значений массива без триггеров. Протестировано на PostgreSQL 10.5.
Т.к. FK для массивов делать нельзя, код функции годится как шаблон для разработки сложных ограничений для проверки элементов массива
(например ltree).
create schema if not exists test;

CREATE OR REPLACE FUNCTION test.check_foreign_key_array(data anyarray, ref_schema text, ref_table text, ref_column text)
    RETURNS BOOL
    RETURNS NULL ON NULL INPUT
    LANGUAGE plpgsql
AS
$body$
DECLARE
    fake_id text;
    sql text default format($$
            select id::text
            from unnest($1) as x(id)
            where id is not null
              and id not in (select %3$I
                             from %1$I.%2$I
                             where %3$I = any($1))
            limit 1;
        $$, ref_schema, ref_table, ref_column);
BEGIN
    EXECUTE sql USING data INTO fake_id;

    IF (fake_id IS NOT NULL) THEN
        RAISE NOTICE 'Array element value % does not exist in column %.%.%', fake_id, ref_schema, ref_table, ref_column;
        RETURN false;
    END IF;

    RETURN true;
END
$body$;

drop table if exists test.t1, test.t2;

create table test.t1 (
    id integer generated by default as identity primary key
);

create table test.t2 (
    id integer generated by default as identity primary key,
    t1_ids integer[] not null check (test.check_foreign_key_array(t1_ids, 'test', 't1', 'id'))
);

insert into test.t1 (id) values (default), (default), (default); --ok
insert into test.t2 (id, t1_ids) values (default, array[1,2,3]); --ok
insert into test.t2 (id, t1_ids) values (default, array[1,2,3,555]); --error
Пример добавления ограничения для типа поля ltree:
alter table region
    add constraint region_tree_path_ids_check
        check (
                tree_path_ids::text ~ '^\d+(\.\d+)*$|^$' -- список родительских id через точку
                and check_foreign_key_array(string_to_array(tree_path_ids::text, '.')::int[], 'public', 'region', 'id')
        )
        not valid; --при необходимости
Поиск по фразе (точный и неточный)
Как найти список строк, совпадающих со списком шаблонов?
-- было
SELECT *
FROM (VALUES
      ('foo bar zap bing'),
      ('man foo'),
      ('bar zap'),
      ('bing'),
      ('foo bar')) AS t(words)
WHERE words LIKE '%bar%' OR words LIKE '%zap%' OR words LIKE '%fix%' OR words LIKE '%new%';

-- стало
SELECT *
FROM (VALUES
      ('foo bar zap bing'),
      ('man foo'),
      ('bar zap'),
      ('bing'),
      ('foo bar')) AS t(words)
WHERE words LIKE ANY (ARRAY['%bar%', '%zap%', '%fix%', '%new%']);
Как получить названия сущностей по поисковой фразе с учётом начала слов (поисковые подсказки)?
См. так же полнотекстовый поиск.
CREATE INDEX /*CONCURRENTLY*/ t_name_trigram_index ON t USING GIN (lower(name) gin_trgm_ops);

WITH
normalize AS (
    SELECT ltrim(REGEXP_REPLACE(LOWER('бар '), '[^а-яёa-z0-9]+', ' ', 'gi')) AS query
),
vars AS (
    SELECT CONCAT('%', REPLACE(quote_like(trim(normalize.query)), ' ', '_%'), '%') AS query_like,
           --CONCAT('(?<![а-яёa-z0-9])', REPLACE(quote_regexp(normalize.query), ' ', '(?:[^а-яёa-z0-9]+|$)')) AS query_regexp
           CONCAT('\m', REPLACE(quote_regexp(normalize.query), ' ', '(?:[^а-яёa-z0-9]+|$)')) AS query_regexp
    FROM normalize
)
SELECT
  t.name,
  lower(t.name) LIKE RTRIM(normalize.query) AS is_leading
FROM t, vars, normalize
WHERE
  length(rtrim(normalize.query)) > 0 -- для скорости
  AND lower(t.name) LIKE vars.query_like -- для скорости
  AND lower(t.name) ~* vars.query_regexp -- для точности
ORDER BY
  is_leading DESC,
  LENGTH(name),
  name
LIMIT 100;
Функции quote_like.sql, quote_regexp.sql
Как для слова с опечаткой (ошибкой) получить наиболее подходящие варианты слов для замены (исправление опечаток)?
Смотри typos_correct
Пример результата запроса
| word_num |
word_from |
is_mistake |
can_correct |
words_to |
words_details |
| 1 |
вадитль |
true |
true |
["водитель"] |
NULL |
| 2 |
дифектолог |
true |
false |
["дефектолог", "директолог", "диетолог"] |
NULL |
| 3 |
формовшица |
true |
true |
["формовщица"] |
NULL |
| 4 |
фрмовщица |
true |
true |
["формовщица"] |
NULL |
| 5 |
бхугалтер |
true |
true |
["бухгалтер"] |
NULL |
| 6 |
лктор |
true |
true |
["лектор"] |
NULL |
| 7 |
дикто |
true |
true |
["диктор"] |
NULL |
| 8 |
вра |
true |
true |
["врач"] |
NULL |
| 9 |
прагромист |
true |
true |
["программист"] |
NULL |
| 10 |
затейник |
false |
false |
NULL |
NULL |
| 11 |
смотритель |
false |
false |
NULL |
NULL |
| 12 |
unknown |
true |
false |
NULL |
NULL |
Описание запроса
- Запрос так же подходит для получения поисковых подсказок (с учётом начала слов), если его немного модернизировать. Практики пока нет, а в теории нужно убрать ограничение по дистанции Левенштейна.
- Запрос использует GIN индекс, поэтому работает быстро.
- Среди пользователей, которые делают опечатки, есть те, которые делают грамматические ошибки. Поэтому, при расчёте расстояния Левенштейна, цена вставки и удаления буквы должна быть выше, чем замены. Цены операций являеются целочисленными числами, которые нам не очень подходят, поэтому приходится делать дополнительный расчёт.
- Пороговые значения подобраны опытным путём.
- Если у нескольких кандидатов подряд рейтинг отличается незначительно, то это не точное исправление (автоисправлять нельзя, только предлагать варианты)
Алгоритм исправления ошибок и опечаток основан поиске совпадающих триграмм (учитывается "похожесть" слова) и на вычислении расстояния Левенштейна.
Точность исправления слова зависит в т.ч. от количества букв в слове.
Получать слова-кандидаты для исправления ошибок необходимо для R > 0.55 и D < 5
| Длина слова, букв (L) |
Максимальная дистанция Левенштейна (D) |
Доля R = (1 − (D ÷ L)) |
| 2 |
0 |
1 |
| 3 |
1 |
0.6666 |
| 4 |
1 |
0.75 |
| 5 |
2 |
0.6 |
| 6 |
2 |
0.6666 |
| 7 |
3 |
0.5714 |
| 8 |
3 |
0.625 |
| 9 |
3 |
0.6666 |
| 10 |
4 |
0.6 |
| 11 |
4 |
0.6363 |
| 12 |
4 |
0.6666 |
| 13 |
4 |
0.6923 |
| 14 и более |
4 |
0.7142 |
Как получить список названий предков и наследников для каждого узла дерева (на примере регионов)?
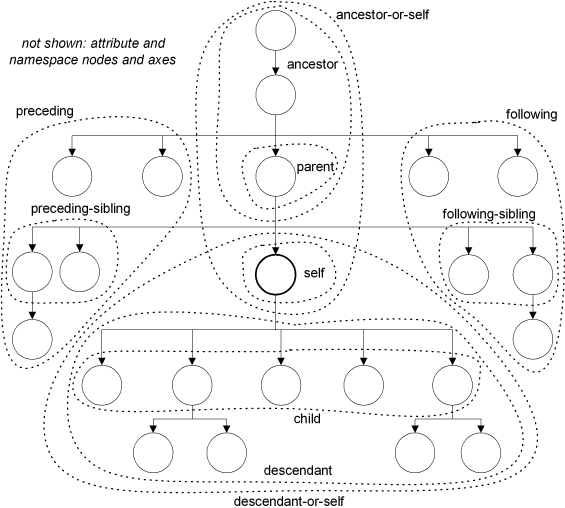
SELECT
    id,
    nlevel(ltree_path) AS level,
    ltree_path AS id_path,
    (SELECT array_agg(st.name ORDER BY nlevel(st.ltree_path)) FROM region AS st WHERE st.ltree_path @> t.ltree_path AND st.ltree_path != t.ltree_path) AS ancestors,
    name AS self,
    (SELECT array_agg(st.name ORDER BY nlevel(st.ltree_path)) FROM region AS st WHERE st.ltree_path <@ t.ltree_path AND st.ltree_path != t.ltree_path) AS descendants
    --, t.*
FROM region AS t
WHERE nlevel(ltree_path) >= 2
ORDER BY nlevel(ltree_path) ASC, ancestors
LIMIT 1000;
Как получить циклические связи в графе?
WITH paths_with_cycle(depth, path) AS (
 WITH RECURSIVE search_graph(parent_id, child_id, depth, path, cycle) AS (
   SELECT g.parent_id, g.child_id, 1,
     ARRAY[g.parent_id],
     false
   FROM custom_query_group_relationship AS g
   UNION ALL
   SELECT g.parent_id, g.child_id, sg.depth + 1,
     path || g.parent_id,
     g.parent_id = ANY(path)
   FROM custom_query_group_relationship AS g, search_graph sg
   WHERE g.parent_id = sg.child_id AND cycle IS FALSE
 )
 SELECT depth, path FROM search_graph WHERE cycle IS TRUE
 ORDER BY depth
)
SELECT DISTINCT path FROM paths_with_cycle
WHERE depth = (SELECT MIN(depth) FROM paths_with_cycle);
Как защититься от циклических связей в графе?
SQL-запросы WITH RECURSIVE... должны иметь защиту от зацикливания! Когда запрос зациклится, он будет выполняться очень долго, съедая ресурсы БД. А ещё таких запросов будет много. Повезёт, если сработает защита самого PostgreSQL.
Как получить названия всех уровней сферы деятельности 4-го уровня?
SELECT ot1.name AS name_1, ot2.name as name_2, ot3.name as name_3, ot4.id as id
    FROM offer_trade ot4
    INNER JOIN offer_trade ot3 ON ot4.order_tree <@ ot3.order_tree AND nlevel(ot3.order_tree) = 3
    INNER JOIN offer_trade ot2 ON ot4.order_tree <@ ot2.order_tree AND nlevel(ot2.order_tree) = 2
    INNER JOIN offer_trade ot1 ON ot4.order_tree <@ ot1.order_tree AND nlevel(ot1.order_tree) = 1;
Оптимизация выполнения запросов
Как посмотреть на план выполнения запроса (EXPLAIN) в наглядном графическом виде?
- Человекопонятное отображение EXPLAIN и советы
- Postgres Explain Visualizer (PEV2) is a tool to show a graphical vizualization of a PostgreSQL execution plan. It creates a graphical representation of the query plan. PEV2 can be run locally without any external internet resource. Simply download index.html, open it in your favorite internet browser.
- PostgreSQL's explain analyze made readable
Как использовать вывод EXPLAIN запроса в другом запросе?
Смотри explain_json.sql
Как ускорить SELECT запросы c тысячами значений в IN(...)?
Источник
Сортировка значений по возрастанию увеличит читабельность кода (TODO: как это повлияет на скорость выполнения запроса?).
-- было
SELECT * FROM t WHERE id < 1000 AND val IN (1, ..., 10000);

-- стало (способ 1)
SELECT * FROM t WHERE id < 1000 AND val IN (VALUES (1), ..., (10000));

-- стало (способ 2)
SELECT * FROM t JOIN (VALUES (1), ..., (10000)) AS t(val) UGING(val) WHERE id < 1000;

-- стало (способ 3)
SELECT * FROM t JOIN UNNEST(ARRAY[1, ..., 10000]) AS t(val) UGING(val) WHERE id < 1000;
Как ускорить SELECT запрос после переезда с PostgreSQL v10 на v12?
-- исходный медленный запрос
SELECT id
FROM t1
WHERE id NOT IN (
    SELECT DISTINCT t2.entity_id FROM t2 WHERE ...
);

-- ключевое слово MATERIALIZED добавлено только в PostgreSQL 12, а у нас пока 10, поэтому см. следующий запрос
WITH t AS MATERIALIZED (
    SELECT DISTINCT t2.entity_id FROM t2 WHERE ...
)
SELECT id
FROM t1
WHERE id NOT IN (SELECT entity_id FROM t);

-- используем массив вместо колонки
SELECT id
FROM t1
WHERE id != ALL(ARRAY( --performance workaround for PostgreSQL 12
    SELECT DISTINCT t2.entity_id FROM t2 WHERE ...
));
Как ускорить SELECT COUNT(*) запрос?
Сценарий использования: SQL запрос, вычисляющий кол-во записей по условию или среднее числовое значение.
Объём данных растёт, а ответ клиенту всегда нужно отдавать очень быстро.
Если SQL запрос оптимизиции уже не поддаётся или очень много данных, то его можно ускорить через приближённые вычисления.
В таком запросе будет погрешность вычислений. Чем быстрее вычисление, тем больше погрешность.
На количествах > 1,000 уже можно использовать приближённые вычисления для задач, требующих немедленного ответа (задачи реального времени).
1,000 или 1,050 - не так важно. При таких значениях у пользователей сохраняется возможность оценки и принятия решения.
А в GUI перед значениями, при необходимости, значение можно показывать так: 1,000+ или ≈1,050 или 1 тыс..
create schema if not exists test;

drop table if exists test.count_approximate;

create table if not exists test.count_approximate as
select md5(i::text) as s from generate_series(1, 10000000) as t(i);

create unique index on test.count_approximate (i);

select count(*)
from (
    select
    from test.count_approximate
    where s ~ 'aa$'
    LIMIT 1000 + 1
) t;
--1 row retrieved starting from 1 in 273 ms (execution: 218 ms, fetching: 55 ms)

-- если предыдущий запрос вернул <= 1000 записей, то больше ничего делать не нужно
-- иначе считаем приближённое количество запией

select count(*) * 100 --39200
from test.count_approximate tablesample bernoulli(1) repeatable (37)
where s ~ 'aa$';
--1 row retrieved starting from 1 in 528 ms (execution: 489 ms, fetching: 39 ms)

select count(*) * 100 --42500
from test.count_approximate tablesample system(1) repeatable (37)
where s ~ 'aa$';
--1 row retrieved starting from 1 in 139 ms (execution: 100 ms, fetching: 39 ms)

-- PostgreSQL < 9.5 ?
select (count(*) filter (where  s ~ 'aa$')) * 100 --38300
from test.count_approximate
where (i % 100) = 0;
--1 row retrieved starting from 1 in 1 s 790 ms (execution: 1 s 767 ms, fetching: 23 ms)

-- для сравнения, подсчёт точного кол-ва записей работает медленно:
select count(*) --38823
from test.count_approximate
where s ~ 'aa$';
--1 row retrieved starting from 1 in 6 s 941 ms (execution: 6 s 899 ms, fetching: 42 ms)
См. Tablesample In PostgreSQL
PostgreSQL extension adding HyperLogLog data structures as a native data type.
Как выполнить функцию N тысяч раз и измерить скорость вы


